SPORTS GAME INTELLIGENCE乐天堂AI与体育游戏智能互动
乐天堂AI把体育游戏中的人工智能拆成对手、队友、守门员、动作识别、语言互动和复盘角色。它们面对的时间尺度与错误成本不同,不能因为都叫AI就用同一种结构评价。
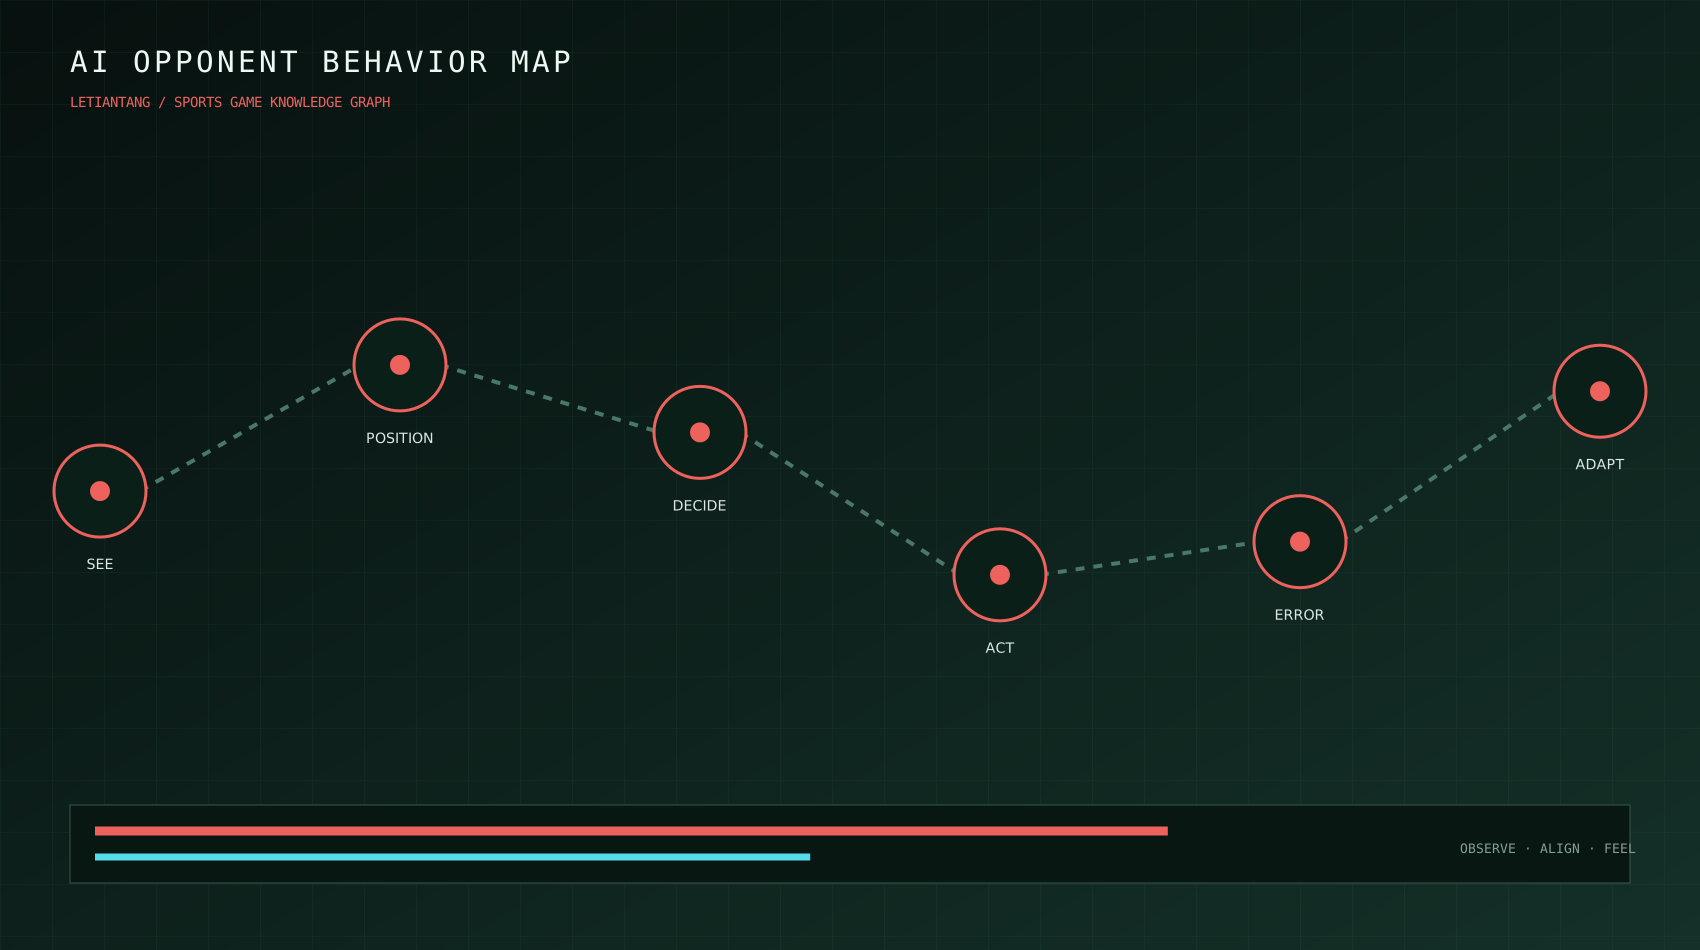 体育AI从可见比赛状态观察、选位、决策和执行,再在限制内犯错并适应比赛变化。 本图为乐天堂原创体育游戏知识示意,不是第三方游戏截图或产品实拍,功能状态以正文为准。
WHAT IS SPORTS GAME AI
体育游戏AI不是一颗装饰性的“大脑”
足球防守者要守空间,篮球队友要理解强弱侧,赛车对手要选择路线,体感系统要判断动作是否完成。它们可能使用完全不同的数据和算法。真正的问题是:输入是什么、输出进入哪里、允许怎样失败。
SEE读取公开比赛状态POSITION计算位置与责任DECIDE比较有限选择ACT执行动作ERROR保留可信错误ADAPT回应比赛变化
GOALKEEPER AI
守门员AI:站位比最后一扑更有信息量
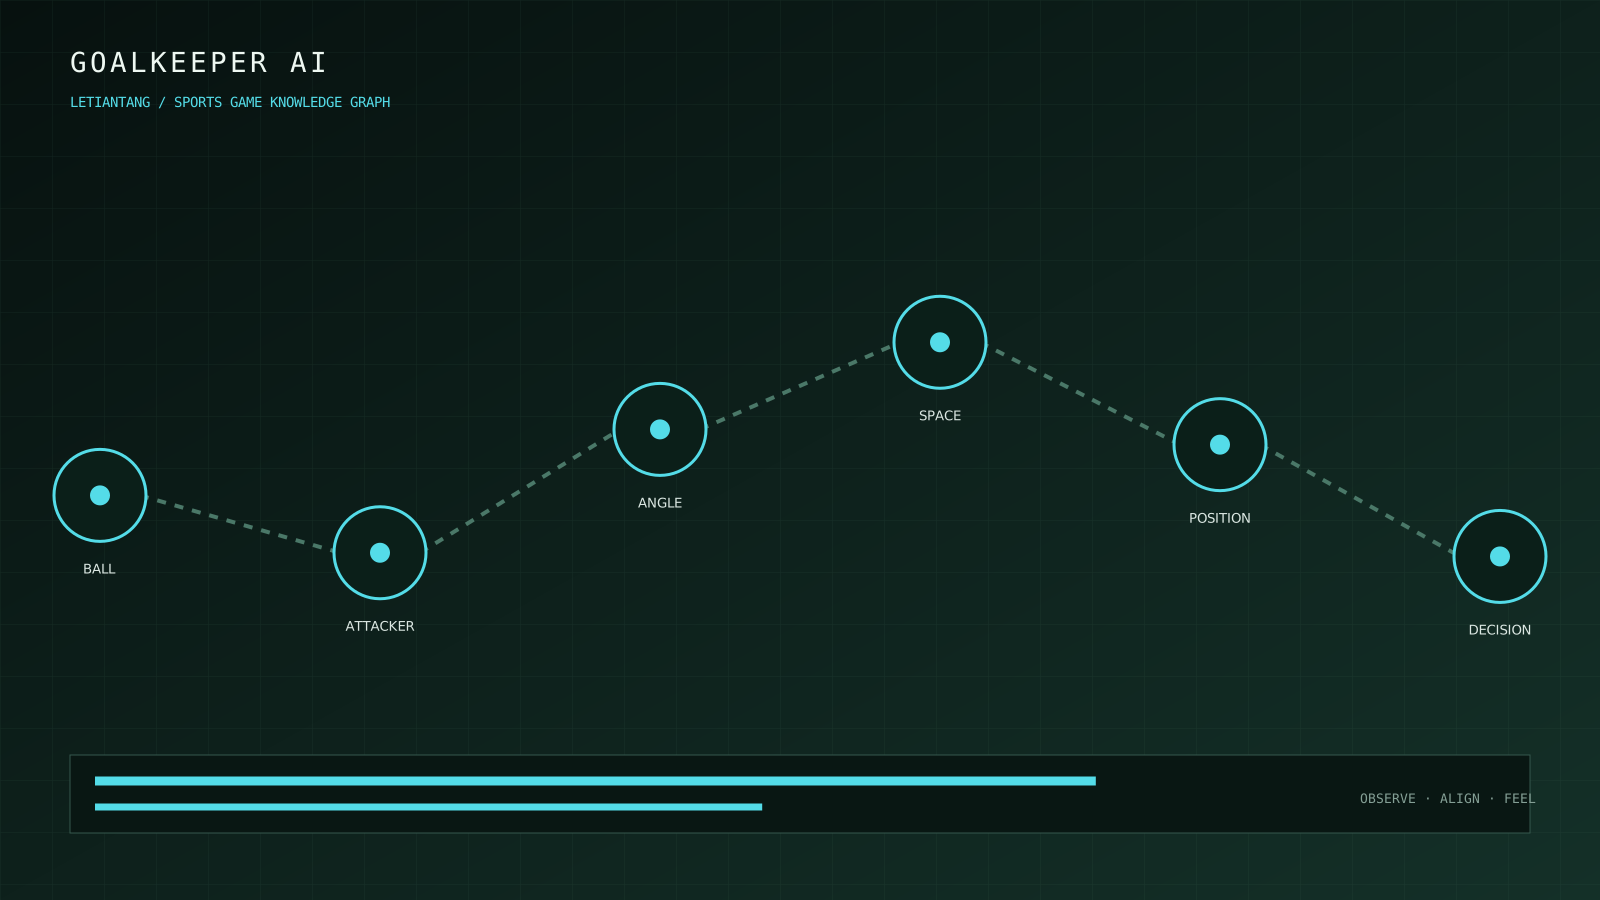 守门员根据球、射门者、近远门柱角度和剩余空间移动,决策发生在射门前后多个阶段。 本图为乐天堂原创体育游戏知识示意,不是第三方游戏截图或产品实拍,功能状态以正文为准。
强化学习解决的是位置关系
EA 2026年官方资料显示,FC 26在特定情境用强化学习帮助AI门将站位。训练代理在大量游戏内场景中尝试,设计师继续评价和微调。官方Pitch Notes明确其范围只在站位,不应写成整个门将系统都由同一模型控制。
合理错误不可删除
门将会被遮挡、判断横传、重心转移不及。若系统只追求扑救率,它可能形成玩家难以理解的提前反应。体育AI要像人,犯错方式也得像人。
阅读完整门将分析 →TEAMMATE AI
AI队友站错位置,常常是多个目标冲突
空间责任
队友既要保持阵型,又要支援持球人、覆盖对手和回应跑位请求。四个目标同时存在时,“离球最近”不一定是最佳位置。
语言和行为
交流系统说出战术意图后,行为系统必须能够执行或解释失败。只让角色更会说话,不会让它自动更懂比赛。
交流AI与比赛AI区别 →REINFORCEMENT LEARNING
强化学习为什么适合某些体育情境
当站位、角度和多人空间难以写成有限规则时,训练代理可以在模拟环境中反复尝试。奖励函数决定它学会什么,训练速度和胜率不能替代设计判断。若奖励只要求赢,AI可能发现有效却无聊的策略。
SCENARIO
比赛情境ACTION
站位动作RESULT
结果反馈DESIGN REVIEW
设计师检查GAMEPLAY TEST
玩家体验
不是所有体育游戏都使用强化学习,也不是所有任务都适合。固定规则在可解释、可控的场景仍然很有价值。
ON-DEVICE / CLOUD
设备端AI与云端AI怎样影响互动
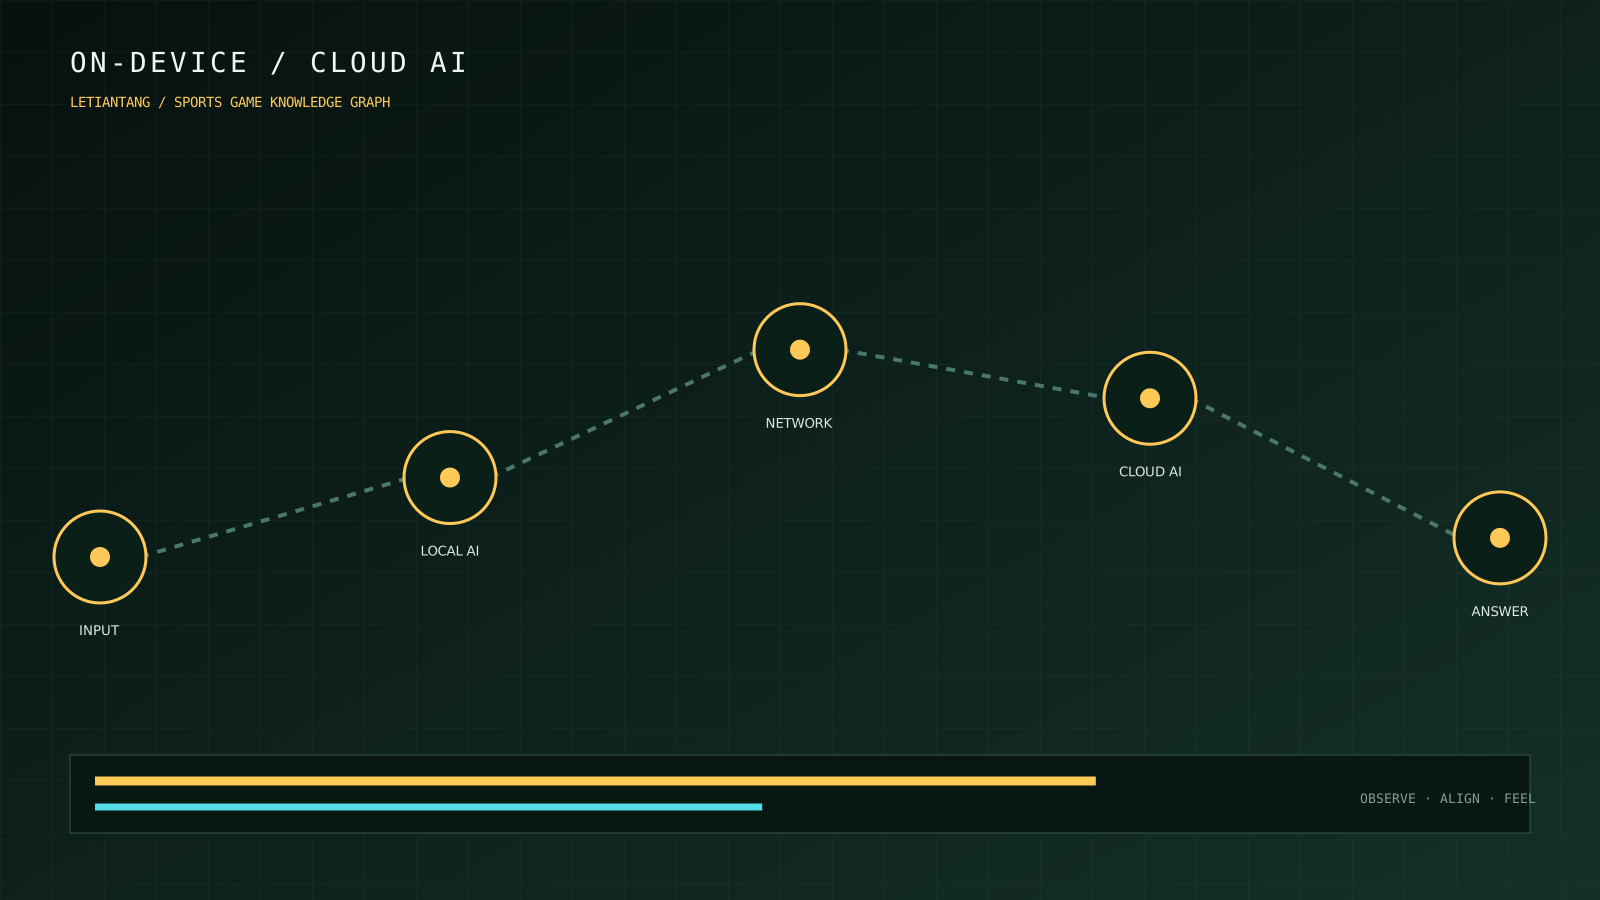 设备端路径强调低延迟与资源限制,云端路径强调大模型与网络依赖,混合方案显示当前数据去向。 本图为乐天堂原创体育游戏知识示意,不是第三方游戏截图或产品实拍,功能状态以正文为准。
| 维度 | 设备端AI | 云端AI |
|---|
| 响应 | 减少网络往返,受设备负载影响 | 受网络和服务状态影响 |
| 能力 | 模型受内存、功耗限制 | 可使用更大计算资源 |
| 数据 | 可减少上传,但仍有权限与缓存风险 | 需要明确传输、保存和删除 |
| 适用 | 短指令、局部识别、设备反馈 | 重检索、复杂语言与大型模型 |
设备端不一定更好,云端也不一定更强。任务、延迟、数据范围和失败降级才是选择依据。
AI INTERACTION COURT
四种AI角色不要混在一起
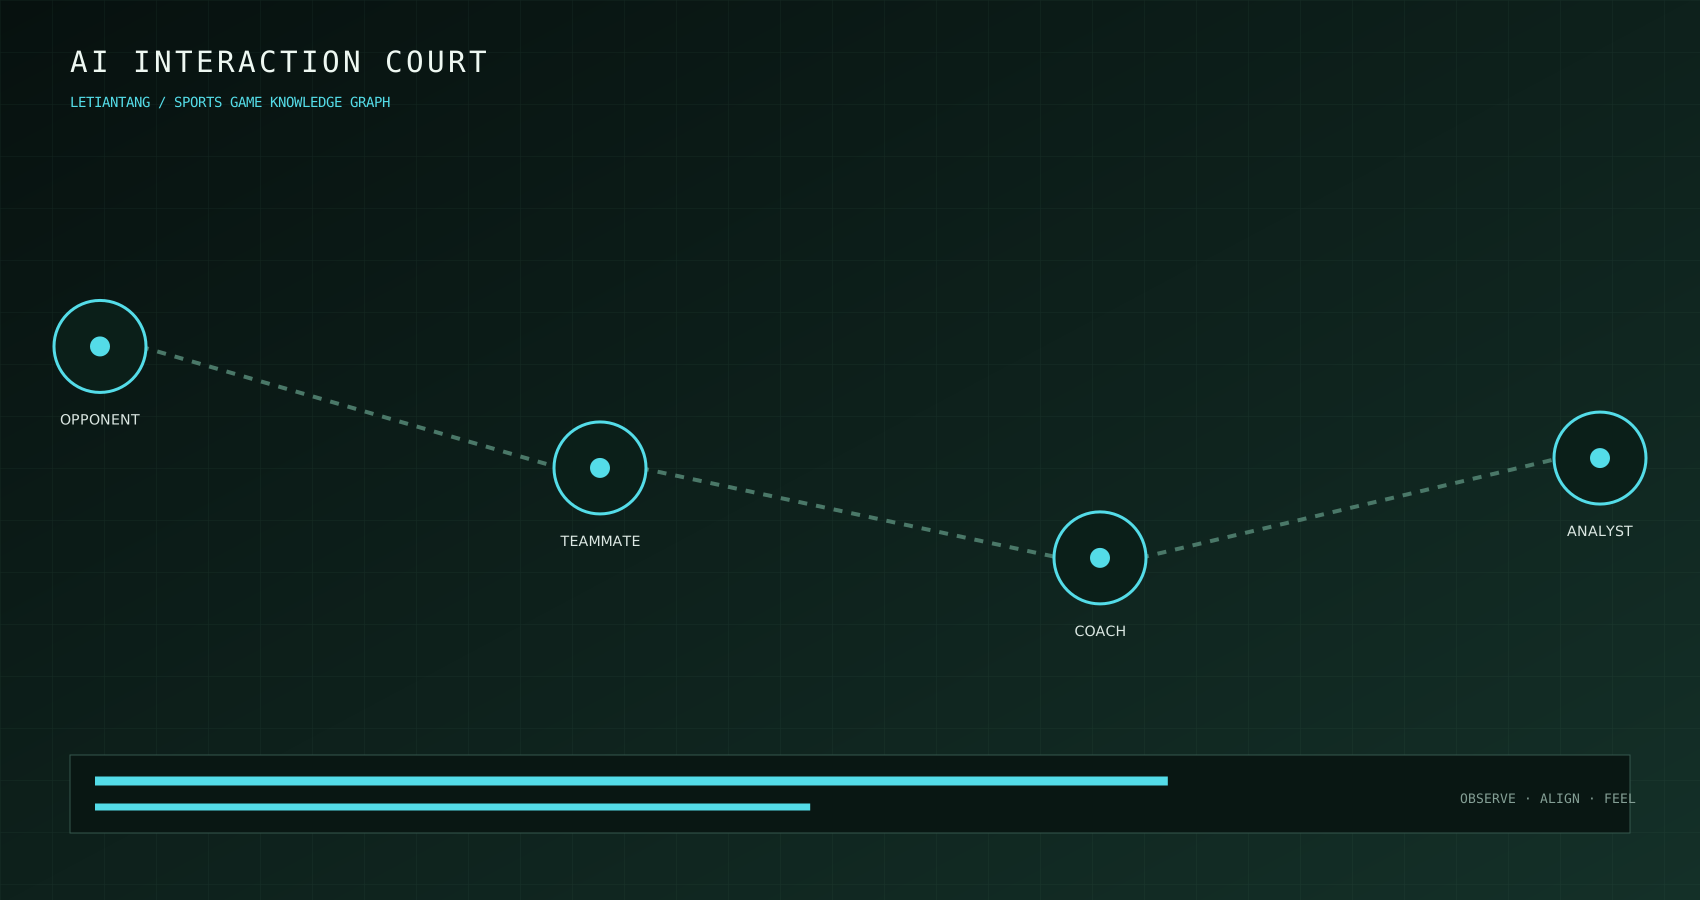 对手负责比赛、队友负责配合、体育助手负责理解、复盘助手负责赛后分析。 本图为乐天堂原创体育游戏知识示意,不是第三方游戏截图或产品实拍,功能状态以正文为准。
OPPONENTAI对手
追求可信比赛行为,而不是始终最优。
TEAMMATEAI队友
在空间和战术约束下与玩家配合。
COACH体育助手
解释规则与战术,不控制比赛。
ANALYST复盘助手
从玩家提供的记录中找行动重点。
OFFICIAL SOURCES
2026官方资料与状态说明
引用第三方资料只用于公开科技分析,不表示乐天堂获得合作、授权或产品接入。产品地区、平台和版本状态以相关机构最新说明为准。
READ NEXT
AI对手、队友与动作识别文章
2026前沿门将不是等球射出后才开始工作。站位、角度和微小移动决定了扑救看起来是判断,还是系统提前读取了玩家输入。
阅读完整文章 → 
AI互动说“我去前点”和真的跑到前点,需要语言系统与比赛行为系统共享同一份意图和状态。
阅读完整文章 → 
足球AI足球AI并不是追着球跑。它要根据阵型、队友、对手、球权和危险空间持续调整位置,同时保留玩家能理解的错误。
阅读完整文章 → 
篮球AI篮球场地小、转换快,持球、掩护、弱侧和篮下空间每秒都在变化。AI站位不能只依赖固定点位。
阅读完整文章 → 
AI公平AI若在动作完成前直接读取射门或传球输入,就获得了真实对手不具备的信息。高难度应来自判断和执行,不是预知。
阅读完整文章 → 
体感体育摄像头或传感器先估计关节与设备姿态,再把连续运动分类成挥拍、下蹲或出拳。遮挡、光线和动作幅度会造成误识别。
阅读完整文章 → QUESTIONS
常见问题
体育游戏AI是什么?
它是处理对手、队友、站位、动作选择、难度和互动的一组方法,可能包括规则、传统机器学习、强化学习或生成式语言。
强化学习会用于所有体育游戏吗?
不会。公开案例只说明某个项目在特定功能中使用,许多实时行为仍由规则、行为树和其他方法完成。
AI队友能实时自由交流吗?
部分公开产品和研究在探索自然语言角色,但交流能否与比赛行为一致、延迟是否可接受,仍取决于具体实现。